
IA · Artículo temático
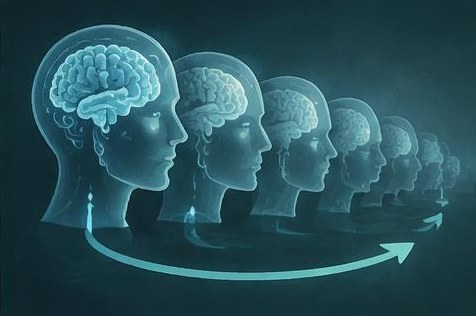
Los datos sintéticos de entrenamiento pueden ser útiles, pero no son un sustituto exento de riesgos de unos datos de partida diversos. La investigación sobre el colapso del modelo estudia qué puede perderse al aprender repetidamente a partir de contenidos generados. La distinción más importante es la siguiente: el uso recursivo e incontrolado de datos no es lo mismo que el uso de ejemplos generados con un propósito específico, verificados y combinados con los datos originales.
Por qué pueden desaparecer los contenidos poco frecuentes
Los modelos generativos solo reproducen de forma aproximada la distribución de sus datos de entrenamiento. Si sus resultados se utilizan después como base para nuevos entrenamientos, las desviaciones pueden amplificarse a lo largo de varias generaciones. El trabajo de Shumailov y sus colegas publicado en Nature estudia este efecto bajo el concepto de colapso del modelo. Uno de los problemas centrales es la pérdida de regiones poco frecuentes de la distribución original. El sistema aprende entonces, cada vez más, a partir de una representación restringida de sus propios resultados anteriores. Por tanto, la publicación constituye una advertencia contra el uso recursivo y acrítico de datos, no una prueba de que cualquier uso de ejemplos sintéticos esté inevitablemente condenado al fracaso. La forma en que se generan y seleccionan los datos, y en que se combinan con el material original, es decisiva. Igualmente importantes son la clase de modelos estudiada y las condiciones concretas en las que se produce y se mide la pérdida de calidad observada.
La procedencia se convierte en información sobre la calidad
Cuando se mezclan contenidos creados por personas y contenidos generados por máquinas, resulta más difícil rastrear su procedencia. Sin embargo, esta distinción sigue siendo importante para los equipos responsables del entrenamiento, porque influye en la composición y la diversidad del conjunto de datos. La propuesta Datasheets for Datasets ofrece un marco útil para ello: deben documentarse, entre otros aspectos, la creación, el procesamiento y el uso previsto. En el caso del material sintético, deben incluirse además los métodos de generación, los criterios de selección y las verificaciones realizadas. Un enunciado de ejercicio formulado automáticamente y con una solución conocida debe evaluarse de manera distinta a una explicación inventada sin ningún control. Incluso los ejemplos que parecen correctos pueden presentar sesgos sistemáticos. Por ello, la evaluación de la calidad debe examinar, además de los errores individuales, la distribución del material en su conjunto, incluidos los casos poco frecuentes, las formulaciones inusuales y los contraejemplos difíciles, que pueden desaparecer fácilmente si la selección es superficial.
No basta con controlar el promedio
Para el desarrollo práctico, es recomendable comparar los resultados con datos de referencia que se conserven sin modificaciones. Estos no deberían proceder de los propios modelos que se estén estudiando. Después de cada cambio importante en los datos, se comprueba si el rendimiento empeora en tareas, lenguas o patrones textuales poco frecuentes. Un promedio estable no es suficiente si se pierde calidad en determinados ámbitos menos representados. Asimismo, debería poder rastrearse qué finalidad cumple cada ejemplo sintético y a qué verificaciones humanas o automáticas se ha sometido. La investigación no proporciona un umbral universal que establezca una proporción de datos generados segura en todos los contextos. Más bien, muestra por qué la procedencia, la diversidad y la evaluación repetida deben abordarse conjuntamente. Los contenidos sintéticos son, por tanto, una herramienta cuya utilidad depende de cómo se diseñe su uso, no un recurso que pueda multiplicarse a voluntad sin repercusiones en el modelo entrenado a partir de ellos.
Fuentes e información adicional
- Shumailov et al.: AI models collapse when trained on recursively generated datanature.com
- Gebru et al.: Datasheets for Datasetsdl.acm.org
Redactado con asistencia de IA a partir de las fuentes mencionadas y con formulación propia. En el texto se diferencian resultados de investigación, prototipos técnicos y conocimientos consolidados. Este artículo temático no es una noticia de última hora.