
IA · Article thématique
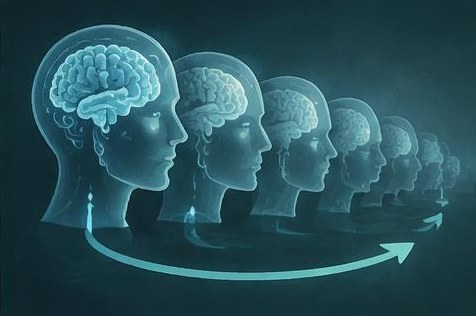
Les données d’entraînement synthétiques peuvent être utiles, mais elles ne remplacent pas sans risque des données initiales diversifiées. Les recherches sur l’effondrement des modèles examinent ce qui peut se perdre lorsque l’apprentissage s’appuie de manière répétée sur des contenus générés. La distinction essentielle est la suivante : une utilisation récursive et incontrôlée des données n’est pas équivalente à l’emploi d’exemples générés de manière ciblée, vérifiés et combinés aux données d’origine.
Pourquoi les contenus rares peuvent disparaître
Les modèles génératifs ne reproduisent qu’approximativement la distribution de leurs données d’entraînement. Lorsque leurs sorties servent ensuite à leur tour de base d’entraînement, les écarts peuvent s’amplifier au fil des générations. L’étude de Shumailov et de ses collègues publiée dans Nature examine cet effet sous le terme d’effondrement des modèles. L’un des problèmes centraux est la perte des zones peu représentées de la distribution d’origine. Le système apprend alors de plus en plus à partir d’une représentation restreinte de ses propres résultats antérieurs. Cette publication constitue donc une mise en garde contre l’utilisation récursive des données sans examen critique, et non la preuve que tout recours à des exemples synthétiques est nécessairement voué à l’échec. La manière dont les données sont générées, sélectionnées et combinées aux données d’origine est déterminante. La classe de modèles étudiée et les conditions précises dans lesquelles la dégradation observée de la qualité apparaît et est mesurée sont tout aussi importantes.
La provenance devient une information sur la qualité
Lorsque des contenus créés par des humains et des contenus générés par des machines sont mélangés, leur provenance devient plus difficile à retracer. Cette distinction reste néanmoins importante pour les équipes chargées de l’entraînement, car elle influe sur la composition et la diversité du corpus. L’approche des Datasheets for Datasets offre à cet égard un cadre utile : il convient notamment de documenter la création, le traitement et l’utilisation prévue des données. Pour les données synthétiques, il faut également consigner les méthodes de génération, les critères de sélection et les vérifications effectuées. Un énoncé d’exercice formulé automatiquement, dont la solution est connue, doit être évalué différemment d’une explication entièrement inventée sans contrôle. Même des exemples qui paraissent corrects peuvent présenter des biais systématiques. Un contrôle de la qualité doit donc examiner, au-delà des erreurs individuelles, la distribution de l’ensemble des données, y compris les cas rares, les formulations inhabituelles et les contre-exemples difficiles, qui peuvent facilement disparaître lors d’une sélection superficielle.
Ne pas se contenter de contrôler la moyenne
Dans la pratique du développement, il est recommandé de procéder à une comparaison avec des données de référence conservées sans modification. Celles-ci ne doivent pas elles-mêmes provenir des modèles en cours d’étude. Après chaque modification importante des données, il faut vérifier si les tâches, les langues ou les structures textuelles rares sont moins bien prises en charge. Une moyenne stable ne suffit pas si la qualité se dégrade dans certaines régions périphériques de la distribution. Il convient également de pouvoir retracer la finalité de chaque exemple synthétique ainsi que les vérifications humaines ou automatiques auxquelles il a été soumis. La recherche ne fournit aucun seuil universel garantissant qu’une proportion donnée de données générées est sans risque dans tous les contextes. Elle montre plutôt pourquoi la provenance, la diversité et les évaluations répétées doivent aller de pair. Les contenus synthétiques constituent ainsi un outil dont l’utilité dépend de la manière dont il est conçu et utilisé, et non une ressource que l’on pourrait multiplier à volonté sans répercussions sur le modèle entraîné à partir de ces contenus.
Sources et informations complémentaires
- Shumailov et al.: AI models collapse when trained on recursively generated datanature.com
- Gebru et al.: Datasheets for Datasetsdl.acm.org
Rédigé avec l’aide de l’IA à partir des sources citées, dans une formulation originale. Le texte distingue les résultats de recherche, les prototypes techniques et les connaissances établies. Cet article thématique n’est pas une actualité du jour.